Xiaomiが独自チップ開発をさらに加速させています。同社は秋のフラッグシップ製品発表イベントで、新たなXringチップを3種類発表しました。その中でも特に注目されるのが、端末上で生成AIを高速に処理するために設計された専用AIアクセラレーター「Xring O100」です。最大1.22TB/sという非常に高速なメモリ帯域幅を実現し、オンデバイスAIの推論速度は毎秒330トークンに達するとXiaomiは説明しています。
メモリ帯域幅は一般的なスマホの16倍
Xring O100の最大の特徴は、AI処理性能だけでなく、プロセッサーとメモリ間のデータ転送速度を大幅に高めている点です。
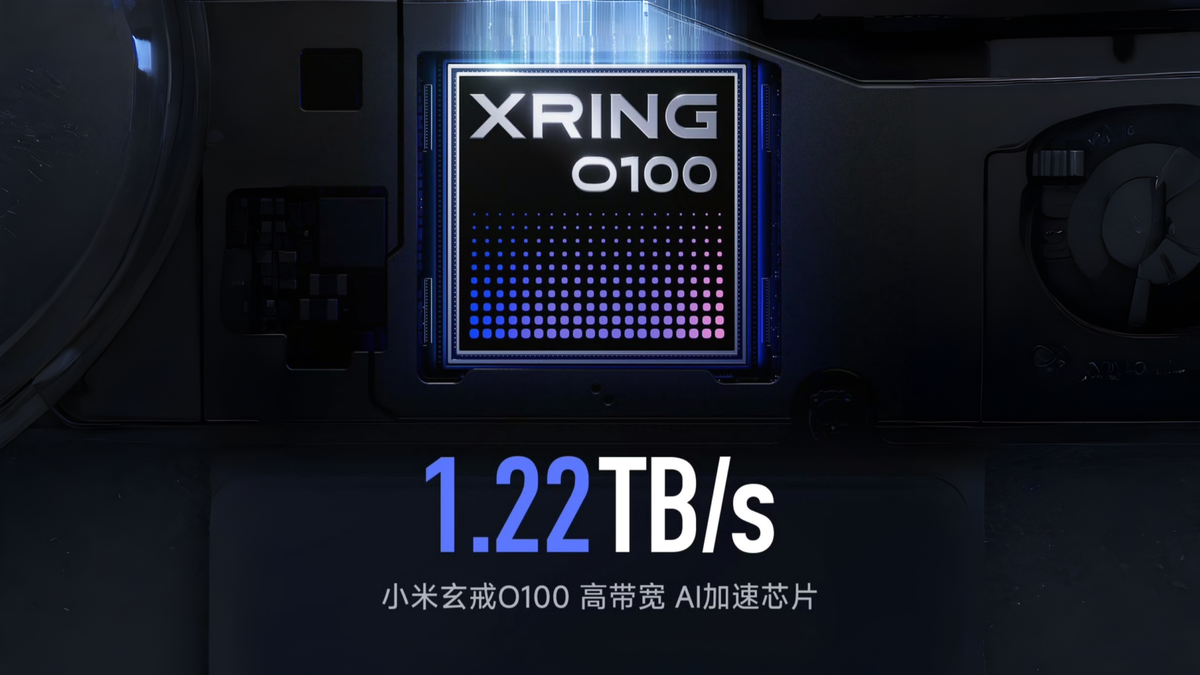
Xiaomiによると、O100は最大1.22TB/sのメモリ帯域幅を実現しており、一般的なスマートフォンと比較して約16倍の帯域幅を確保しています。
これはAI処理において大きな意味を持ちます。大規模言語モデルを端末上で動作させる場合、演算性能が十分に高くても、プロセッサーとメモリの間でデータを素早く移動できなければ処理速度が伸びません。いわゆるメモリ帯域幅のボトルネックが、オンデバイスAIの性能を制限する要因になっていました。
O100は、この問題をメモリそのものとの距離を縮めることで解決しようとしています。
ロジックとDRAMを3次元に積層
Xring O100では、ロジックダイと高速DRAMを垂直方向に積層する「Wafer-on-Wafer」技術を採用しています。さらに、ハイブリッドボンディングによって両者を高密度に接続することで、演算部分とメモリ間の物理的な距離を短縮しています。
Xiaomiは、O100を世界初の6nmプロセスによる3Dウェハーレベル積層の先進パッケージング技術と位置付けています。接続ピッチも物理的な限界に近い水準まで狭めているとされ、高速なデータ転送を実現するためにパッケージング技術そのものを重視した設計になっています。
単純に半導体の製造プロセスを微細化するだけではなく、チップとメモリの接続方法を工夫することでAI性能を引き出すというのが、Xring O100の大きな特徴です。
330TPSのオンデバイスAIを実現
AI処理用のNPUは複数のコアで構成され、それぞれ異なる推論処理に対応できるよう最適化されています。また、処理内容に応じてデータを動的に振り分ける仕組みも採用されています。
その結果として、Xiaomiはオンデバイス推論で毎秒330トークンという速度を実現できるとしています。クラウドへデータを送信することなく端末側でAI処理を行えるため、応答速度だけでなくプライバシーやオフライン環境での利用にもメリットがあります。
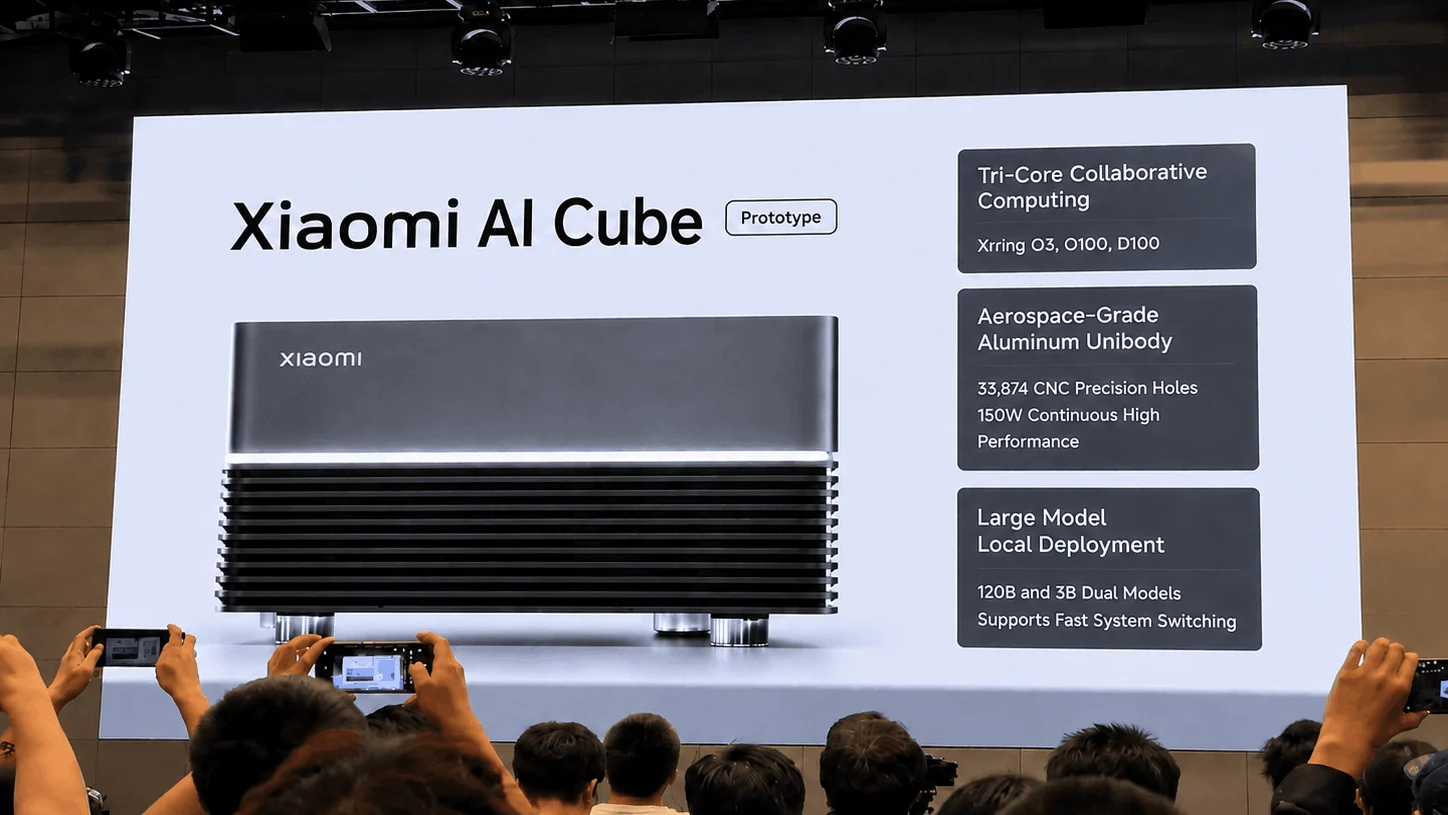
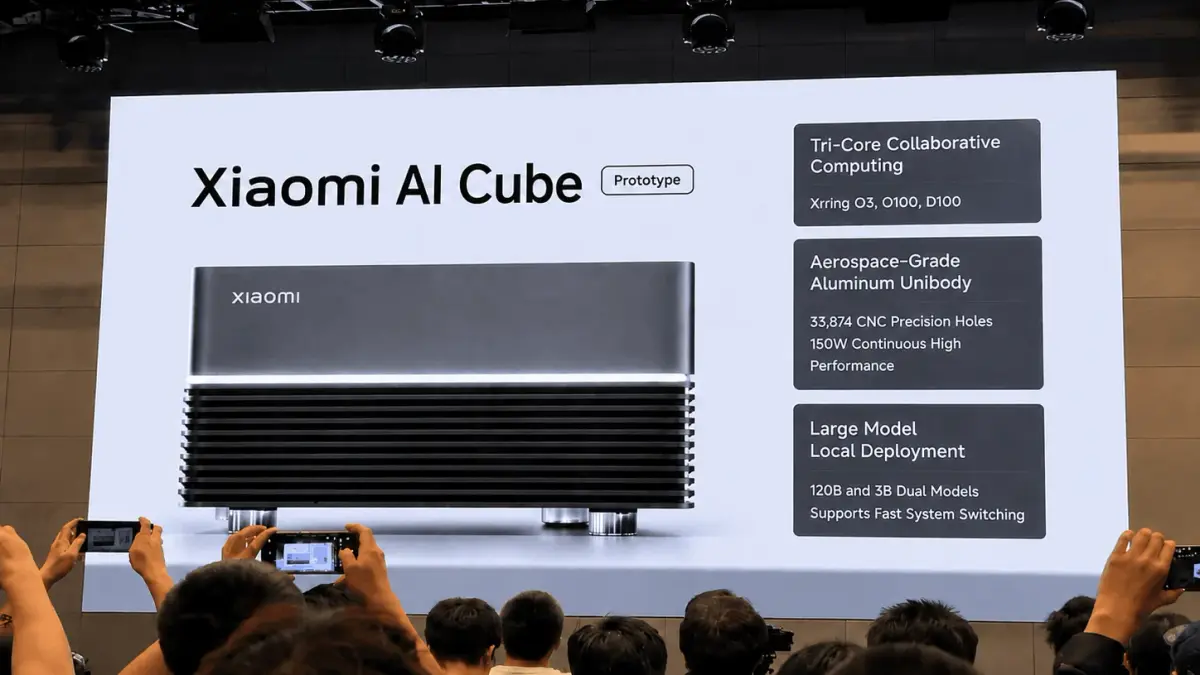
Xiaomiはすでに、O100を搭載したタブレット型端末や「Xiaomi AI Cube」と呼ばれる小型PCのプロトタイプも公開しています。O100単体ではなく、ほかのXringチップと組み合わせることで、長時間にわたるローカルAI処理にも対応する構成が想定されています。
2027年からスマホやロボットなどへ展開へ
Xring O100は、Xiaomiが進める独自半導体戦略の一部です。Xringシリーズにはスマートフォン向けのフラッグシップSoCだけでなく、自動車向けのチップなども含まれています。
今回のO100では、最先端の製造プロセスだけを追求するのではなく、メモリ帯域幅や3D積層、パッケージング技術によってAI性能を引き上げる方向性が明確になっています。
商用製品への搭載は2027年以降が予定されており、スマートフォンやタブレット、ロボットなどへの展開が見込まれています。
生成AIの処理をクラウドに依存するのではなく、端末側で高速かつプライベートに実行する流れが強まるなか、XiaomiはXring O100をそのための重要な基盤にしようとしています。1.22TB/sという圧倒的なメモリ帯域幅と330TPSの推論性能が実際の製品でどこまで発揮されるのか、今後の展開が注目されます。