Xiaomiが、表形式のデータを扱うためのオープンソース基盤モデル「Xiaomi-TabLDM」を公開しました。金融や医療、製造、物流など、表形式のデータを大量に扱う分野での利用を想定したモデルで、データセットごとに個別の再学習やチューニングを行わなくても、分類や回帰といったタスクに対応できるのが特徴です。
近年は生成AIや大規模言語モデルに注目が集まっていますが、実際の企業活動では、顧客情報や製品データ、センサーデータなど、表形式に整理されたデータを分析する機会も少なくありません。Xiaomi-TabLDMは、こうした構造化データを対象とした基盤モデルとして開発されています。
合成データだけで事前学習
Xiaomi-TabLDMの大きな特徴は、構造的因果モデル(SCM)によって生成した合成データのみを使って事前学習している点です。
学習用データは、規模や変数の種類、変数間の依存関係、データを生成する際の機能的な関係などに幅を持たせており、さまざまな表形式データに対応できるよう設計されています。
モデルのアーキテクチャには、特徴量同士の関係をより細かく捉えるためのデュアルストリーム特徴グルーピングや、軽量なアテンション残差、Sparse Mixture-of-Experts(MoE)などを採用しています。これにより、計算負荷を大きく増やすことなくモデルの処理能力を高めています。
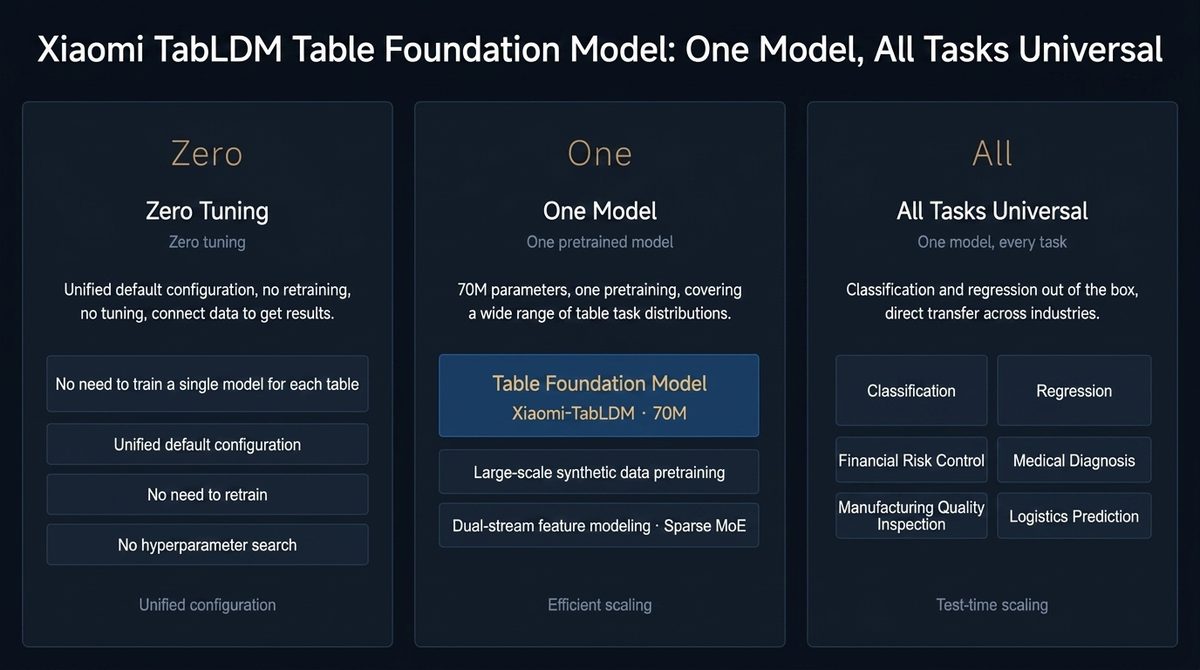
さらに推論時には「Test-Time Scaling」を利用します。これは学習済みのパラメータ自体を変更するのではなく、推論時の計算量を増やすことで予測精度を高める仕組みです。
複数のベンチマークで上位の成績
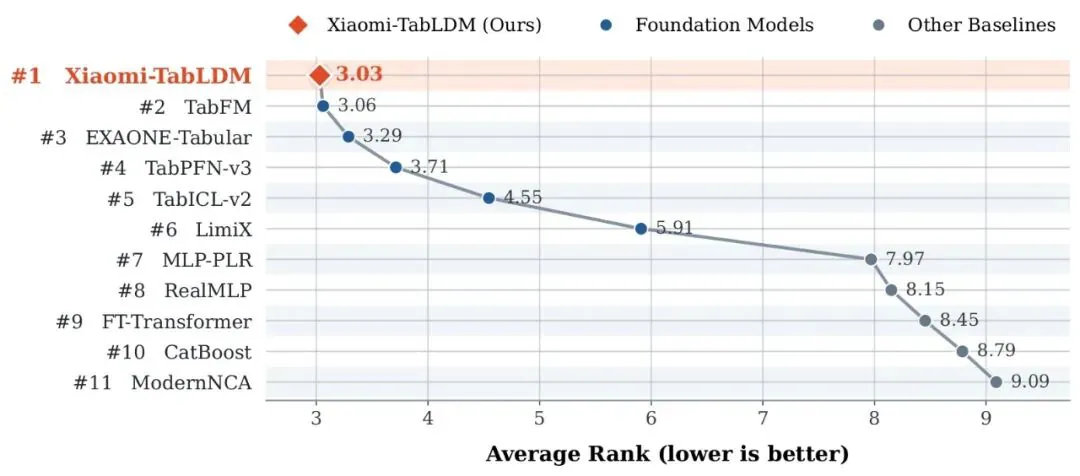
性能面でも、Xiaomi-TabLDMは複数の公開ベンチマークで高い結果を記録しています。
OpenML-CTR23では回帰タスクで1位となったほか、TALENT、TabArena、BCCOの回帰タスクでも2位に入りました。また、分類タスクではTALENTのバイナリ分類でトップとなっています。
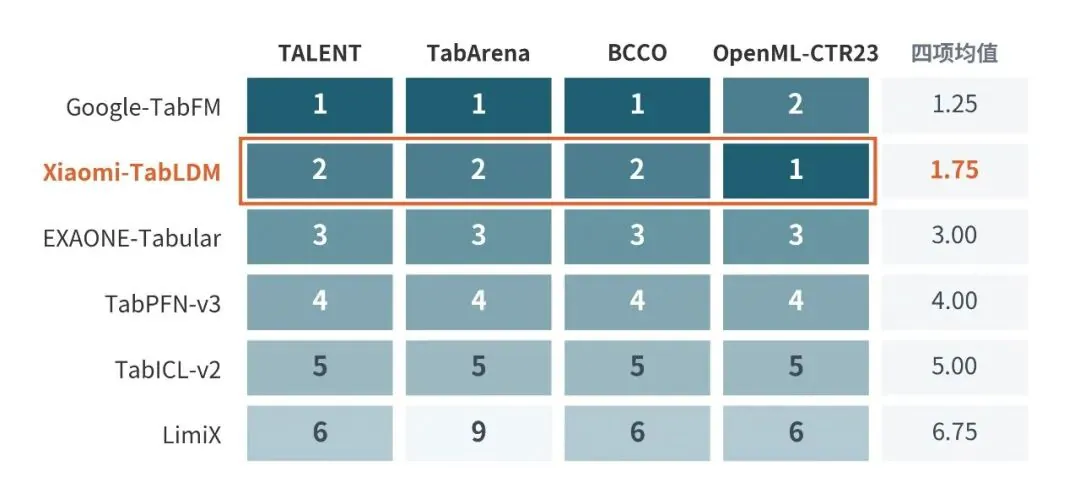
特に注目されるのが、性能だけでなく処理効率も重視している点です。
TabArenaの回帰ベンチマークでは、Xiaomi-TabLDMは2番目に高いEloレーティングを記録しました。一方で、トップモデルとされるTabFMと比較すると、学習時間を82%、推論時間を68%削減したとXiaomiは説明しています。
単純に最高精度を目指すだけではなく、実際に利用する際の計算コストや処理速度も意識した設計になっているようです。
実際の製造現場でも精度を改善
Xiaomiは、実際の産業用途を想定した検証でも成果を確認したとしています。
材料特性の予測では、追加のファインチューニングを行わない状態で予測精度が130%向上し、無効なサンプルのテストを約90%削減したとしています。
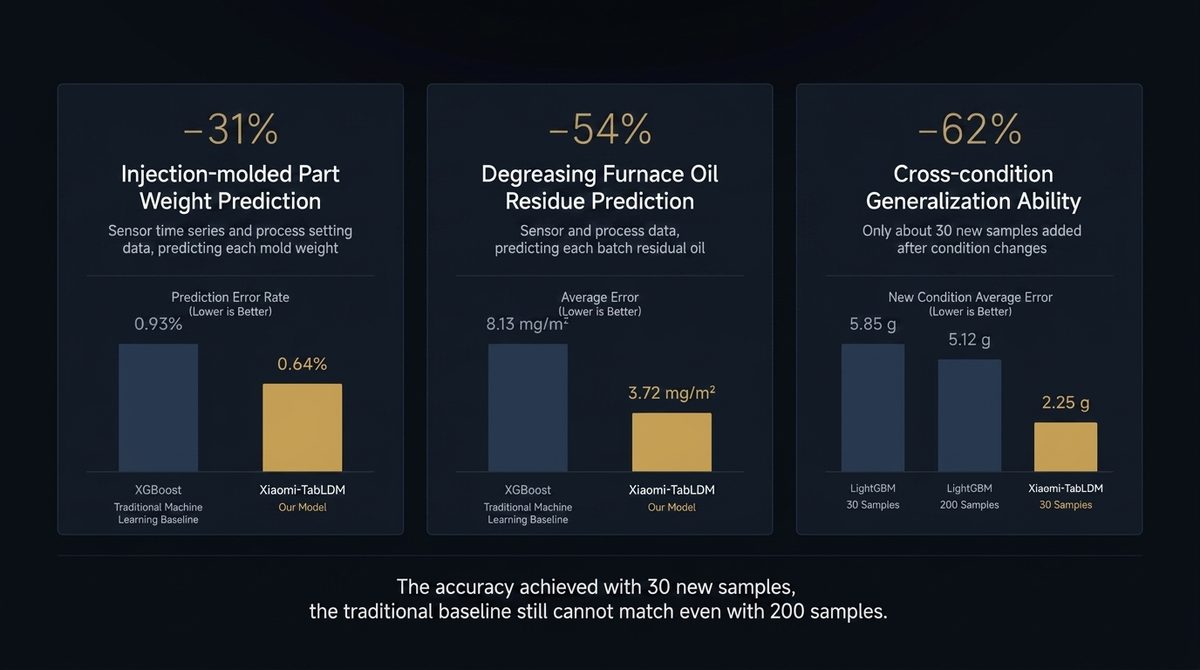
部品重量の予測では、誤差の大きいサンプルの割合を31%削減。さらに、生産条件が変化したケースでは、わずか約30件の新しいサンプルを追加してモデルを適応させることで、平均誤差をさらに62%削減できたとしています。
従来の機械学習手法として広く利用されているXGBoostなどと比較しても、高い精度と適応性を示したというのがXiaomiの主張です。
こうした結果が事実であれば、毎回異なるデータセットに合わせてモデルを作り直す必要性を減らせるため、製造業をはじめとする企業でのAI導入を効率化できる可能性があります。
コードと学習済みモデルをオープンソースで公開
Xiaomi-TabLDMは、scikit-learnとの互換性を備えており、pipを使って導入できます。
Xiaomiはモデルのコードだけでなく、学習済みの重みも公開しているため、研究者や開発者が実際にモデルを試すことも可能です。
今回のXiaomi-TabLDMは、画像や文章などを対象とするAIモデルとは異なり、企業活動で頻繁に利用される表形式データに特化した基盤モデルという点が特徴です。
複数のベンチマークで高い性能を示しながら、学習や推論に必要な時間も抑えることを目指しているため、研究用途だけでなく、実際の業務へのAI導入を検討する企業にとっても興味深い選択肢となりそうです。
Xiaomiが今後このモデルをどのように発展させ、金融、製造、物流などの実用分野へ広げていくのかにも注目されます。