Googleが公開している、Androidアプリ開発におけるAIモデルの性能を比較するベンチマーク「Android Bench」が10月26日に更新されました。今回、新たにGoogleのGemini 4 ArgonやOpenAIのGPT-6.1 Sol、AnthropicのClaude Sonnet 5.5などが追加されましたが、Google自身の最新モデルであるGemini 4 Argonは、競合モデルを下回る結果となっています。
Claude Sonnet 5.5が首位、GPT-6.1 Solはコスト面で強み
Android Benchは、Android開発に特化したテストを通じて、AIモデルがコーディング支援にどの程度適しているかを評価する指標です。Android特有の開発要件やベストプラクティスを考慮しており、モデルの性能だけでなく、開発者が導入コストも比較できるよう平均コストも掲載されています。
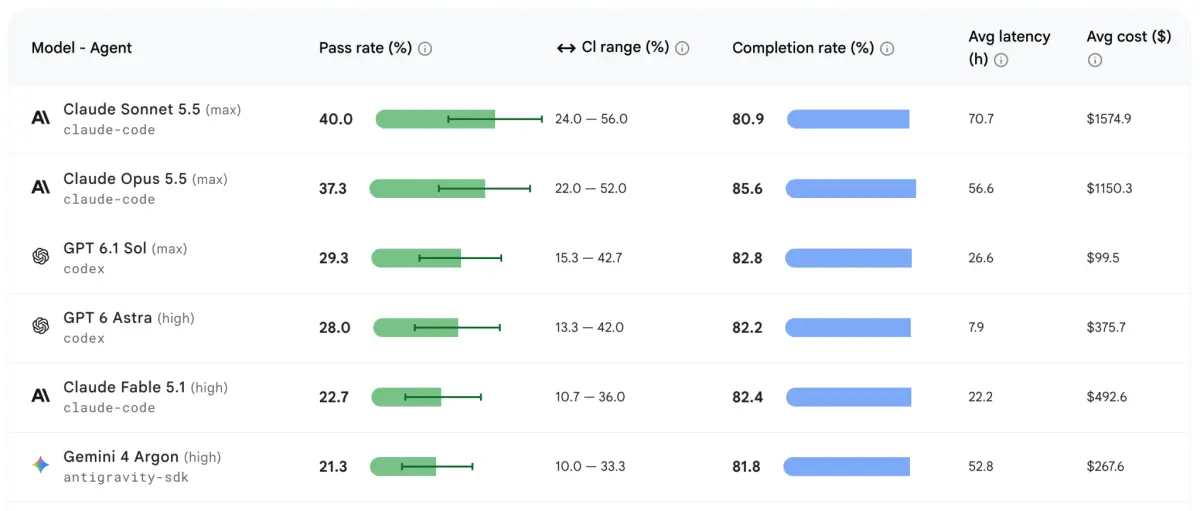
今回の更新では、各モデルで使用した推論レベルも表示されるようになりました。新たに追加されたモデルには、OpenAIのGPT-6 SolとGPT-6.1 Sol、AnthropicのClaude Sonnet 5とSonnet 5.5、GoogleのGemini 4 Argonが含まれています。
ランキングで首位に立ったのはClaude Sonnet 5.5です。テストの合格率は40%、完了率は80.9%でした。10月上旬に追加されたClaude Opus 5.5も2位につけており、Anthropicのモデルが上位を占めています。
一方、注目されるのがGPT-6.1 Solのコストパフォーマンスです。合格率は29.3%、完了率は82.8%で、完了率では首位のClaude Sonnet 5.5を上回っています。さらに、平均コストは99.50ドルとされており、首位モデルの1,574.90ドルと比べて大幅に低くなっています。
Gemini 4 Argonは5位にとどまる
GoogleのGemini 4 Argonは、今回のランキングで5位となりました。合格率は21.3%、完了率は81.8%、平均コストは267.70ドルです。合格率では上位モデルに差をつけられており、Claude Fable 5.1にも及びません。
ただし、完了率だけを見ると81.8%を記録しており、GPT-6.1 Solの82.8%に近い水準です。今回の結果では、タスクを最後まで完了できるかどうかと、テストで求められる基準を満たせるかどうかで、モデルごとの差が表れています。
Gemini 4 Argonについては、発表直後にも、一部のコーディングタスクへの対応に苦戦しているとの内部関係者の指摘が報じられていました。一方、Googleは当時、モデルの能力を擁護していたとされています。
今回のAndroid Benchの結果だけで、Gemini 4 Argonのコーディング性能全般を判断することはできません。それでも、Android開発に特化したGoogle自身のベンチマークで競合モデルに後れを取ったことは、同社にとって気になる結果といえそうです。