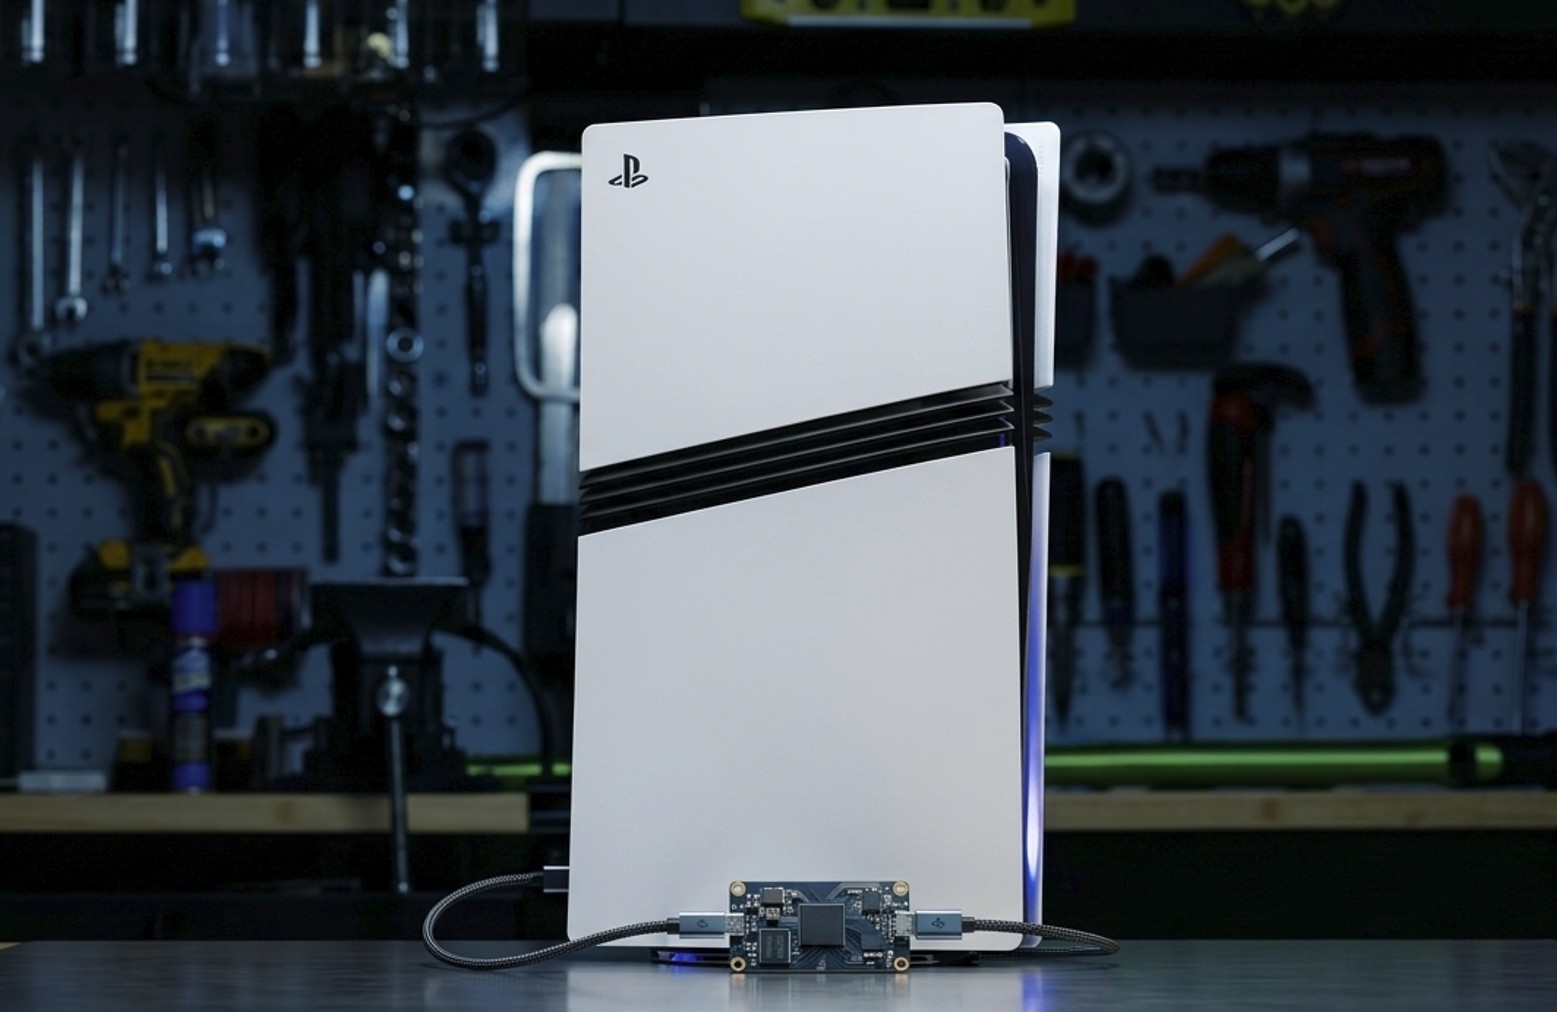
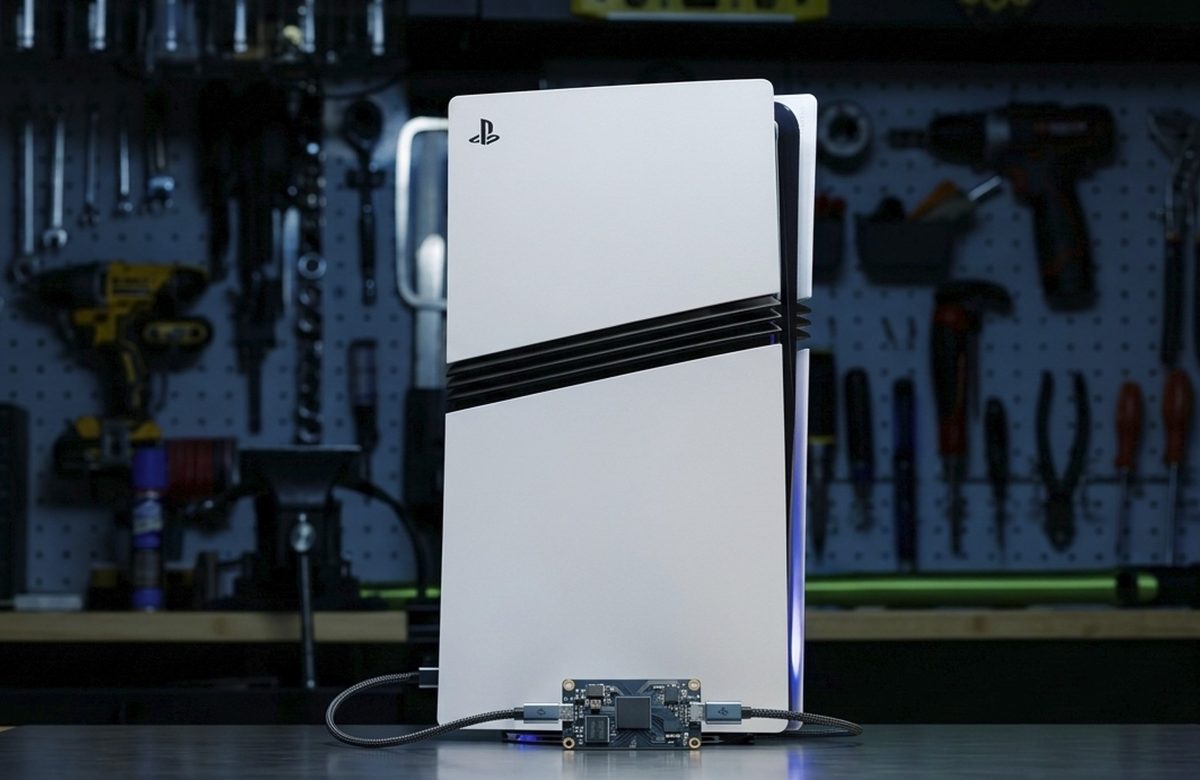
ソニーのPlayStation 5(PS5)を脱獄し、ローカルAIサーバーとして活用する実験が行われました。ゲーム向けに設計されたPS5上で、270億パラメータの大規模言語モデル(LLM)を動作させることに成功したと報告されています。小型モデルでは毎秒124トークンという生成速度も記録していますが、メモリ容量やAIの回答品質など、いくつかの制約も明らかになっています。
Vulkanを利用した移植で使用可能なメモリが増加
今回のプロジェクトは「PS5LM」と呼ばれるもので、Reddit上で公開された情報によると、PS5でAIモデルを実行するために、オープンソースの推論エンジン「llama.cpp」を移植しています。
当初の非公式移植版ではCPUを利用して処理を行っていましたが、この方式ではAIモデルに使用できるメモリが約6GBに制限されていました。大規模なモデルを動かすには厳しい条件だったため、別のユーザーが移植方法を改良しました。
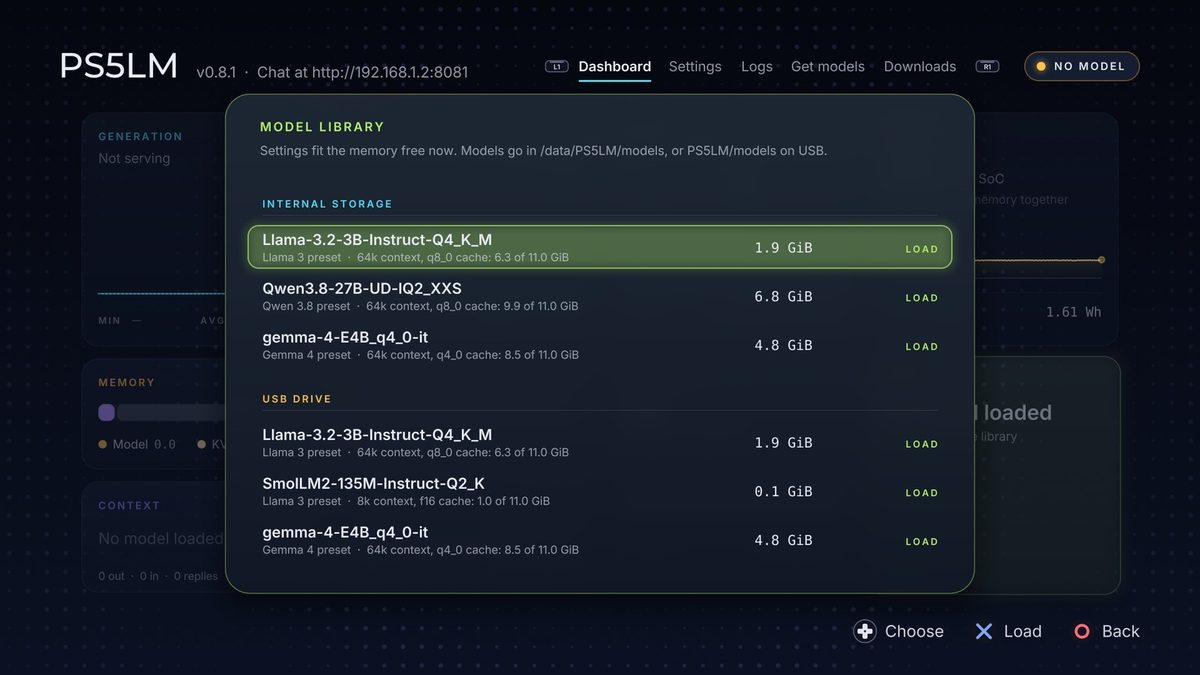
具体的には、MesaのオープンソースAMD GPUドライバーであるRADVを通じてVulkanを利用し、llama.cppをPS5向けのネイティブアプリとして動作させています。この変更によって、AIモデルに利用できるメモリは約11.4GBまで増加しました。
PS5は16GBのGDDR6メモリを搭載し、メモリ帯域幅は448GB/sに達します。ゲーム向けのハードウェアとしては十分な帯域幅を備えており、GPUを中心に処理することで、ローカルAIの実行環境としても一定の性能を発揮したようです。
270億パラメータのモデルを毎秒20.9トークンで実行
今回動作させたのは、270億パラメータを持つ「Qwen3.8-27B」です。ただし、通常の精度で実行するにはメモリが足りません。
仮に16ビット精度でモデルの重みを保持する場合、必要なメモリ容量は約54GBに達します。16GBのメモリしか搭載していないPS5では、そのまま実行することは困難です。
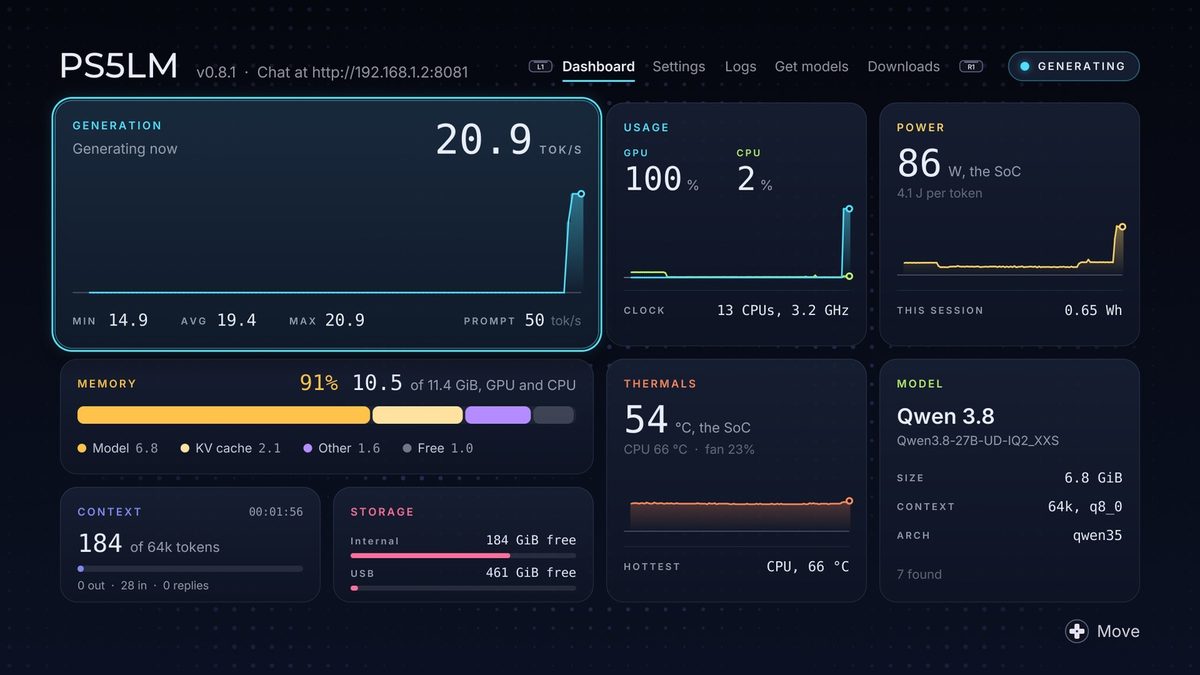
そこで、モデルの重みを大幅に圧縮する量子化が利用されました。今回試された「Qwen3.8-27B-UD-IQ2_XXS」は、重みをおおむね2ビット相当で保持することで、モデルのサイズを約6.8GBに抑えています。コンテキスト長を64Kトークンに設定した状態でも、メモリ使用率は91%に収まったと報告されています。
実行中のGPU使用率は100%に達した一方、CPU使用率は2%にとどまりました。この状態でのトークン生成速度は毎秒20.9トークンです。PS5のメモリ帯域幅を生かし、GPU主体でLLMを動かせていることがうかがえます。
小型モデルでは毎秒124トークンを記録
より小型のAIモデルでは、生成速度がさらに向上しています。報告された数値は次のとおりです。
- Qwen3.8-27B:毎秒20.9トークン
- Gemma 4 E4B:毎秒61トークン
- Llama 3.2 3B:毎秒124トークン
特にLlama 3.2 3Bでは毎秒124トークンに達しており、PS5がローカルAIの実行環境としても活用できる可能性を示しています。
また、実験時の消費電力は合計86Wで、温度は54度だったとされています。ゲームをプレイするために設計された家庭用ゲーム機であることを考えると、興味深い結果です。
大幅な量子化による品質低下や脱獄のリスクも
もっとも、今回の結果をそのまま実用的なAI環境として評価するのは早計です。
まず、270億パラメータのモデルを実行できたとはいえ、メモリ容量の制約から、モデルを大幅に量子化する必要があります。量子化はメモリ使用量を削減できる一方、回答の正確性や推論能力が低下する可能性があります。そのため、通常の精度で動作させた場合と同等の品質が得られるとは限りません。
また、PS5でllama.cppのネイティブアプリを動作させるには、本体の脱獄が必要です。脱獄によってメーカー保証に影響が及ぶ可能性があるほか、PlayStation Networkの利用制限やオンラインゲームでのアカウント停止などのリスクもあります。
今回の実験は、PS5のGPUやメモリ帯域幅がゲーム以外の用途にも応用できることを示すものです。ただし、メモリ容量の限界や量子化による品質面の妥協、脱獄に伴うリスクを考慮すると、一般ユーザーが手軽に導入できるローカルAI環境とはいえません。あくまで、既存のゲーム機をAI処理に転用した技術的な実験として注目される事例です。